
Veel B2B-teams verwerken nog steeds documenten door regels over te typen, velden te controleren en bijlagen naast elkaar te leggen. Denk aan orderinformatie, transportdocumenten, productspecificaties, leverbonnen of documenten van leveranciers. Het werk is vaak niet moeilijk, maar wel precies. Eén verkeerd veld kan later voor vertraging, herstelwerk of discussie zorgen.
AI kan hier veel waarde toevoegen. Niet door elke beslissing definitief over te nemen, maar door het leeswerk en voorwerk te versnellen. Een goed ontworpen human-in-the-loop workflow laat AI documenten omzetten naar conceptdata. Daarna controleert een medewerker de uitkomst, corrigeert waar nodig en zet de verwerking pas daarna door.
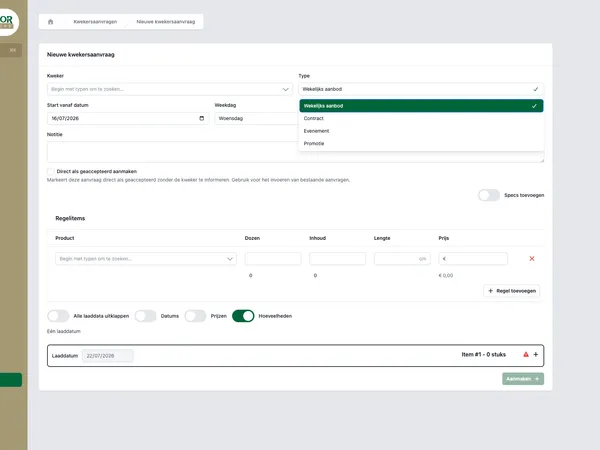
Dat principe zie je ook terug in het publieke voorbeeld van Equaflor AI Jobs. Documenten van kwekers worden daar voorbereid als conceptzendingen, waarna menselijke controle de laatste stap blijft. Dit artikel zoomt in op dat ontwerpprincipe: wanneer werkt het, welke keuzes moet je maken en wanneer vraagt dit om maatwerk?
Documentverwerking is meestal een workflow-vraagstuk
Wie naar documentverwerking kijkt als puur AI-probleem, mist vaak de kern. De vraag is niet alleen: kan een model tekst herkennen? De vraag is vooral: hoe past die herkenning veilig in het bestaande proces?
In veel organisaties lopen documenten via e-mail, gedeelde mappen, portals of exports uit andere systemen. Medewerkers openen een bestand, zoeken de relevante informatie, vergelijken die met bestaande data en vullen daarna een systeem. Dat proces bevat meerdere soorten werk:
- Herkennen welk type document is aangeleverd.
- Uitlezen van velden zoals referenties, aantallen, datums, adressen of productcodes.
- Controleren of de data logisch is ten opzichte van bestaande records.
- Aanvullen van ontbrekende informatie.
- Beslissen wat er moet gebeuren bij afwijkingen.
AI kan vooral helpen bij de eerste twee onderdelen en soms bij het signaleren van afwijkingen. De beslissing wat daarna gebeurt, hoort in veel B2B-processen bewust bij een medewerker te blijven. Zeker als fouten direct effect hebben op planning, facturatie, voorraad of klantafspraken.
Waarom volledig automatisch niet altijd verstandig is
Volledige automatisering klinkt aantrekkelijk. Geen wachttijd, geen handwerk, geen terugkerende taken. Toch is het bij documentverwerking vaak verstandiger om eerst met conceptdata te werken.
Documenten zijn namelijk zelden perfect gestandaardiseerd. Leveranciers gebruiken andere templates. Een pdf bevat soms scanruis. Een veldnaam verandert. Een bijlage mist een pagina. Een orderregel staat net anders omschreven dan in het eigen systeem. AI kan daar goed mee omgaan, maar niet foutloos.
Daarom is het belangrijk om onderscheid te maken tussen drie niveaus van automatisering:
- AI leest het document en doet een voorstel.
- AI vult conceptdata in en markeert onzekerheden.
- AI verwerkt definitief zonder menselijke controle.
Voor veel B2B-processen is niveau twee de gezonde tussenstap. Medewerkers besparen tijd omdat het meeste voorwerk klaarstaat. Tegelijk blijft de organisatie in controle over uitzonderingen, twijfelgevallen en definitieve verwerking.
Bij Equaflor werd in de bestaande AI Jobs workflow publiek beschreven dat het voorbereiden van een zending ongeveer 15 seconden kost om te beoordelen, waar dit eerder 10 tot 20 minuten per zending kon vragen. Ook zijn er meer dan 100 zendingen via die workflow verwerkt. Zulke resultaten komen niet door controle te negeren, maar door controle beter te positioneren.
Human-in-the-loop betekent dat AI voorbereidt en de medewerker beslist wat definitief wordt.
Hoe een human-in-the-loop workflow eruitziet
Een goede workflow is concreet. Niet alleen een AI-model dat ergens tekst uit haalt, maar een keten waarin elke stap een duidelijke verantwoordelijkheid heeft.
Een praktisch proces in stappen
- Het document komt binnen via een afgesproken kanaal, bijvoorbeeld upload, e-mail of koppeling.
- Het systeem bepaalt het documenttype en koppelt het aan de juiste verwerkingsregel.
- AI leest relevante velden uit en zet die om naar gestructureerde conceptdata.
- Het systeem vergelijkt de uitkomst met bestaande data, zoals klant, leverancier, product of order.
- Onzekere velden, ontbrekende waarden en afwijkingen worden zichtbaar gemarkeerd.
- Een medewerker controleert de conceptdata en past deze waar nodig aan.
- Na goedkeuring wordt de data definitief verwerkt in het juiste systeem.
- De uitkomst, correcties en uitzonderingen worden gelogd voor analyse en verbetering.
De menselijke stap is dus geen los controlemoment aan het einde. Het is onderdeel van het ontwerp. De interface moet medewerkers snel laten zien wat goed lijkt, waar twijfel zit en welke actie nodig is.
Daar zit vaak het verschil tussen een demo en een bruikbaar bedrijfsproces. Een demo laat zien dat AI iets kan herkennen. Een productiewaardige workflow zorgt dat teams erop kunnen werken, ook als documenten afwijken.
Wat je per leverancier of documenttype moet vastleggen
Documentverwerking wordt sterker als je kennis over leveranciers, documenttypes en procesregels expliciet maakt. Niet elke leverancier gebruikt dezelfde termen. Niet elk document heeft dezelfde prioriteit. Niet elke afwijking hoeft hetzelfde behandeld te worden.
Leg daarom per documentstroom vast wat het systeem moet weten:
- Welke velden verplicht zijn voor verdere verwerking.
- Welke veldnamen of synoniemen vaak voorkomen.
- Welke waarden automatisch te matchen zijn met bestaande data.
- Welke afwijkingen altijd menselijke aandacht vragen.
- Welke toleranties acceptabel zijn, bijvoorbeeld bij aantallen of datums.
- Welke documenten nooit automatisch mogen worden goedgekeurd.
Dit hoeft niet altijd complex te zijn. Soms begint het met een simpele set regels per leverancier. Later kun je die uitbreiden met herkenning van templates, validaties en koppelingen met interne systemen.
Belangrijk is dat deze regels beheersbaar blijven. Als alleen een ontwikkelaar ze kan aanpassen, wordt elke kleine wijziging traag. Als iedereen ze zonder controle kan wijzigen, ontstaat risico. Het juiste ontwerp hangt af van je team, proces en foutgevoeligheid.
Regels per leverancier of documenttype maken AI-uitkomsten beter controleerbaar.
Logging en foutafhandeling bepalen of teams erop vertrouwen
Bij AI in bedrijfsprocessen draait vertrouwen niet om mooie beloftes. Het draait om zichtbaarheid. Een medewerker moet kunnen zien waarom iets wordt voorgesteld, wat onzeker is en wat er gebeurt na correctie.
Daarom zijn logging en foutafhandeling geen bijzaak. Ze horen in het ontwerp vanaf de eerste versie.
Wat je minimaal wilt vastleggen
- Welk document is verwerkt.
- Welke velden zijn uitgelezen.
- Welke velden zijn aangepast door een medewerker.
- Welke validaties zijn geslaagd of mislukt.
- Welke uitzonderingen zijn ontstaan.
- Wie de definitieve verwerking heeft goedgekeurd.
Met die informatie kun je patronen herkennen. Misschien levert één leverancier vaak ontbrekende data aan. Misschien wordt een bepaald veld structureel verkeerd geïnterpreteerd. Misschien is een validatieregel te streng. Zonder logging blijft dat giswerk.
Foutafhandeling moet ook praktisch zijn. Een document dat niet goed gelezen wordt, mag niet verdwijnen in een technische foutmelding. Het moet op een duidelijke plek terechtkomen, met een status en vervolgstap. Bijvoorbeeld: opnieuw beoordelen, doorsturen naar een specialist of terugvragen bij de leverancier.
Wanneer vraagt AI documentverwerking om maatwerk?
Er bestaan standaardtools voor documentherkenning en extractie. Die kunnen waardevol zijn, vooral bij eenvoudige documentstromen. Maatwerk wordt interessant zodra documentverwerking onderdeel is van een breder bedrijfsproces.
Denk aan situaties waarin:
- Documentdata direct gekoppeld moet worden aan orders, zendingen, voorraad of facturatie.
- Er meerdere leveranciers of documentformats naast elkaar bestaan.
- Medewerkers een eigen controle-interface nodig hebben.
- Er specifieke validaties gelden die niet in een standaardtool passen.
- Uitzonderingen volgens vaste procesregels afgehandeld moeten worden.
- Logging, rechten en auditability belangrijk zijn.
In die gevallen gaat het niet meer alleen om uitlezen. Het gaat om procesontwerp, softwarearchitectuur en integratie. Dan wil je bepalen welke delen standaard kunnen, welke delen maatwerk nodig hebben en hoe het geheel onderhoudbaar blijft.
House of Devs werkt vaker aan dit type procesautomatisering, waarbij software aansluit op de manier waarop teams echt werken. Lees ook hoe we kijken naar bedrijfsprocessen automatiseren en onze aanpak voor maatwerk software.
Van experiment naar betrouwbaar proces
Een goede start is klein, maar niet vrijblijvend. Kies één documentstroom met genoeg volume en duidelijke pijn. Breng het huidige proces in kaart. Meet hoeveel tijd het kost, waar fouten ontstaan en welke uitzonderingen vaak terugkomen.
Daarna kun je een eerste versie bouwen waarin AI conceptdata voorbereidt en medewerkers die data beoordelen. Juist in die fase leer je veel. Welke velden zijn stabiel? Welke documenten geven problemen? Waar moet de interface sneller? Welke correcties komen steeds terug?
De stap naar een betrouwbaar proces vraagt om iteratie:
- Begin met een afgebakende documentstroom.
- Maak de controle door medewerkers snel en duidelijk.
- Log correcties en uitzonderingen vanaf dag één.
- Verbeter regels en validaties op basis van echt gebruik.
- Breid pas daarna uit naar meer leveranciers, documenttypes of systemen.
Zo voorkom je dat AI een los experiment blijft. Je bouwt een workflow waarin technologie het repetitieve werk voorbereidt en mensen de controle houden waar dat nodig is.
Wil je onderzoeken waar dit in jouw organisatie waarde kan toevoegen? Neem dan contact op met House of Devs. We denken graag mee over een praktische eerste stap, zonder de complexiteit van je proces weg te poetsen.